这张图片是蓝色背景的科研相关宣传图,左上角有“研知有术”的标识,主视觉文字为“专业的科研推进与成果支持平台”“让研究成为你的能力”,中部带有搜索栏,可搜索“研知有术”。图中还展示了四个用于获取相关内容的社交账号入口,分别是微信公众号、视频号、抖音和小红书。该图与大模型学习相关的开源项目背景无直接关联,是配套的科研平台宣传内容。
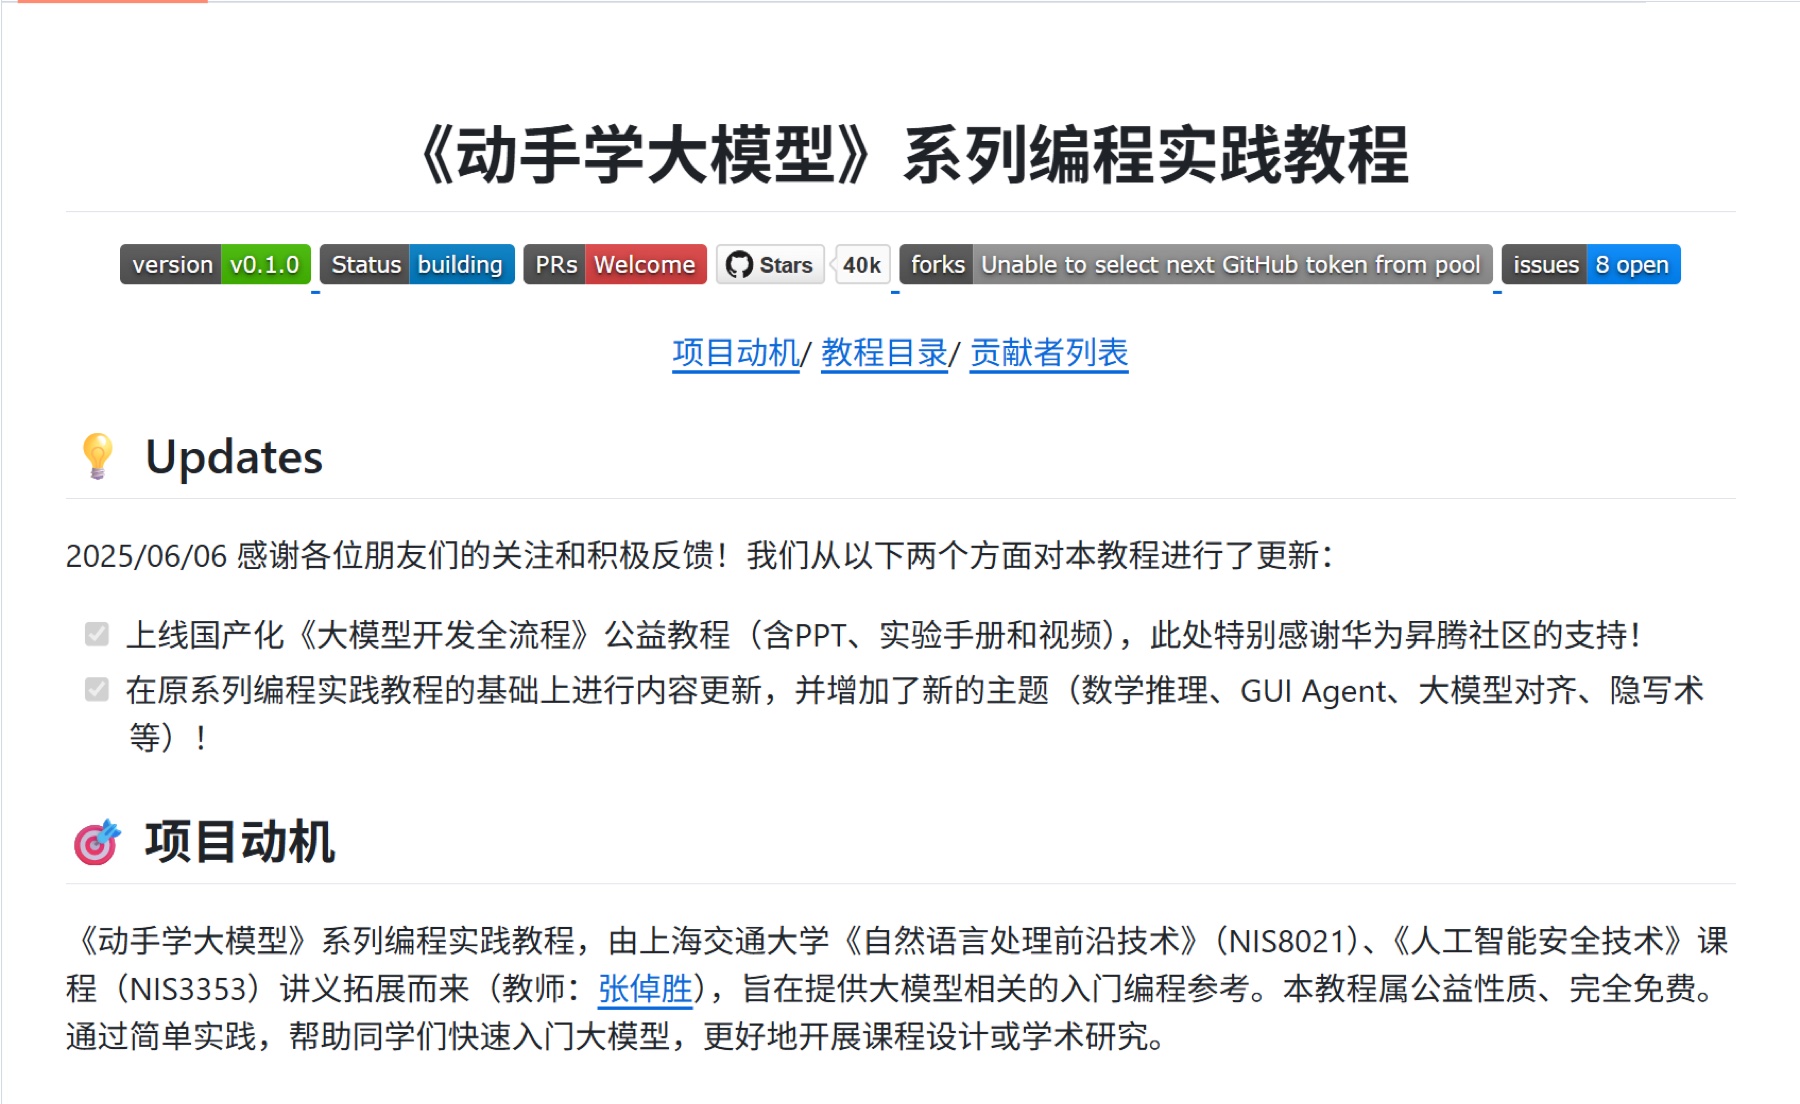
图片展示了《动手学大模型》系列编程实践教程的GitHub页面。页面上方显示版本为v0.1.0,状态为building,有40k颗星星、8个开放问题。下方有“项目动机/教程目录/贡献者列表”选项。更新部分提到2025/06/06对教程进行了更新,包括上线国产化大模型公益教程及在原系列编程实践教程基础上增加新主题等内容。项目动机部分介绍该教程由上海交通大学相关课程讲义拓展而来,旨在提供大模型入门编程参考,属公益性质、完全免费。

仓库名称:dive-into-llms(《动手学大模型 Dive into LLMs》系列编程实践教程)GitHub 地址:https://github.com/Lordog/dive-into-llms

这是上海交通大学张倬胜团队开发的大模型实战编程教程,源自《自然语言处理前沿技术》与《人工智能安全技术》课程讲义,公益免费开源,已获3.4 万 + 星标,单日新增最高 3500+,是国内大模型领域顶流教程。

仓库核心包含11 个实战主题,覆盖大模型全技术栈:从基础微调部署、提示学习与思维链,到进阶知识编辑、模型水印、越狱攻击,再到前沿多模态模型与智能体开发,形成完整学习路径。

三大核心优势:

  1. 零门槛上手:配套 PDF 课件、Markdown 教程与可直接运行的 Jupyter Notebook,支持腾讯云 Cloud Studio 在线运行,无需本地环境配置
  2. 国产化适配:提供华为昇腾全流程教程,兼容国产 AI 芯片生态
  3. 实战导向:聚焦代码复现与工程实现,避免理论堆砌,每章含完整实验流程与结果分析

适合人群包括硕博研究生、科研工作者与 AI 开发者,可用于课程设计、学术研究与工程落地。使用方式灵活:在线直接运行 Notebook,或克隆仓库本地部署(支持 Python 3.10,依赖清单完整)。

项目部分内容截图:
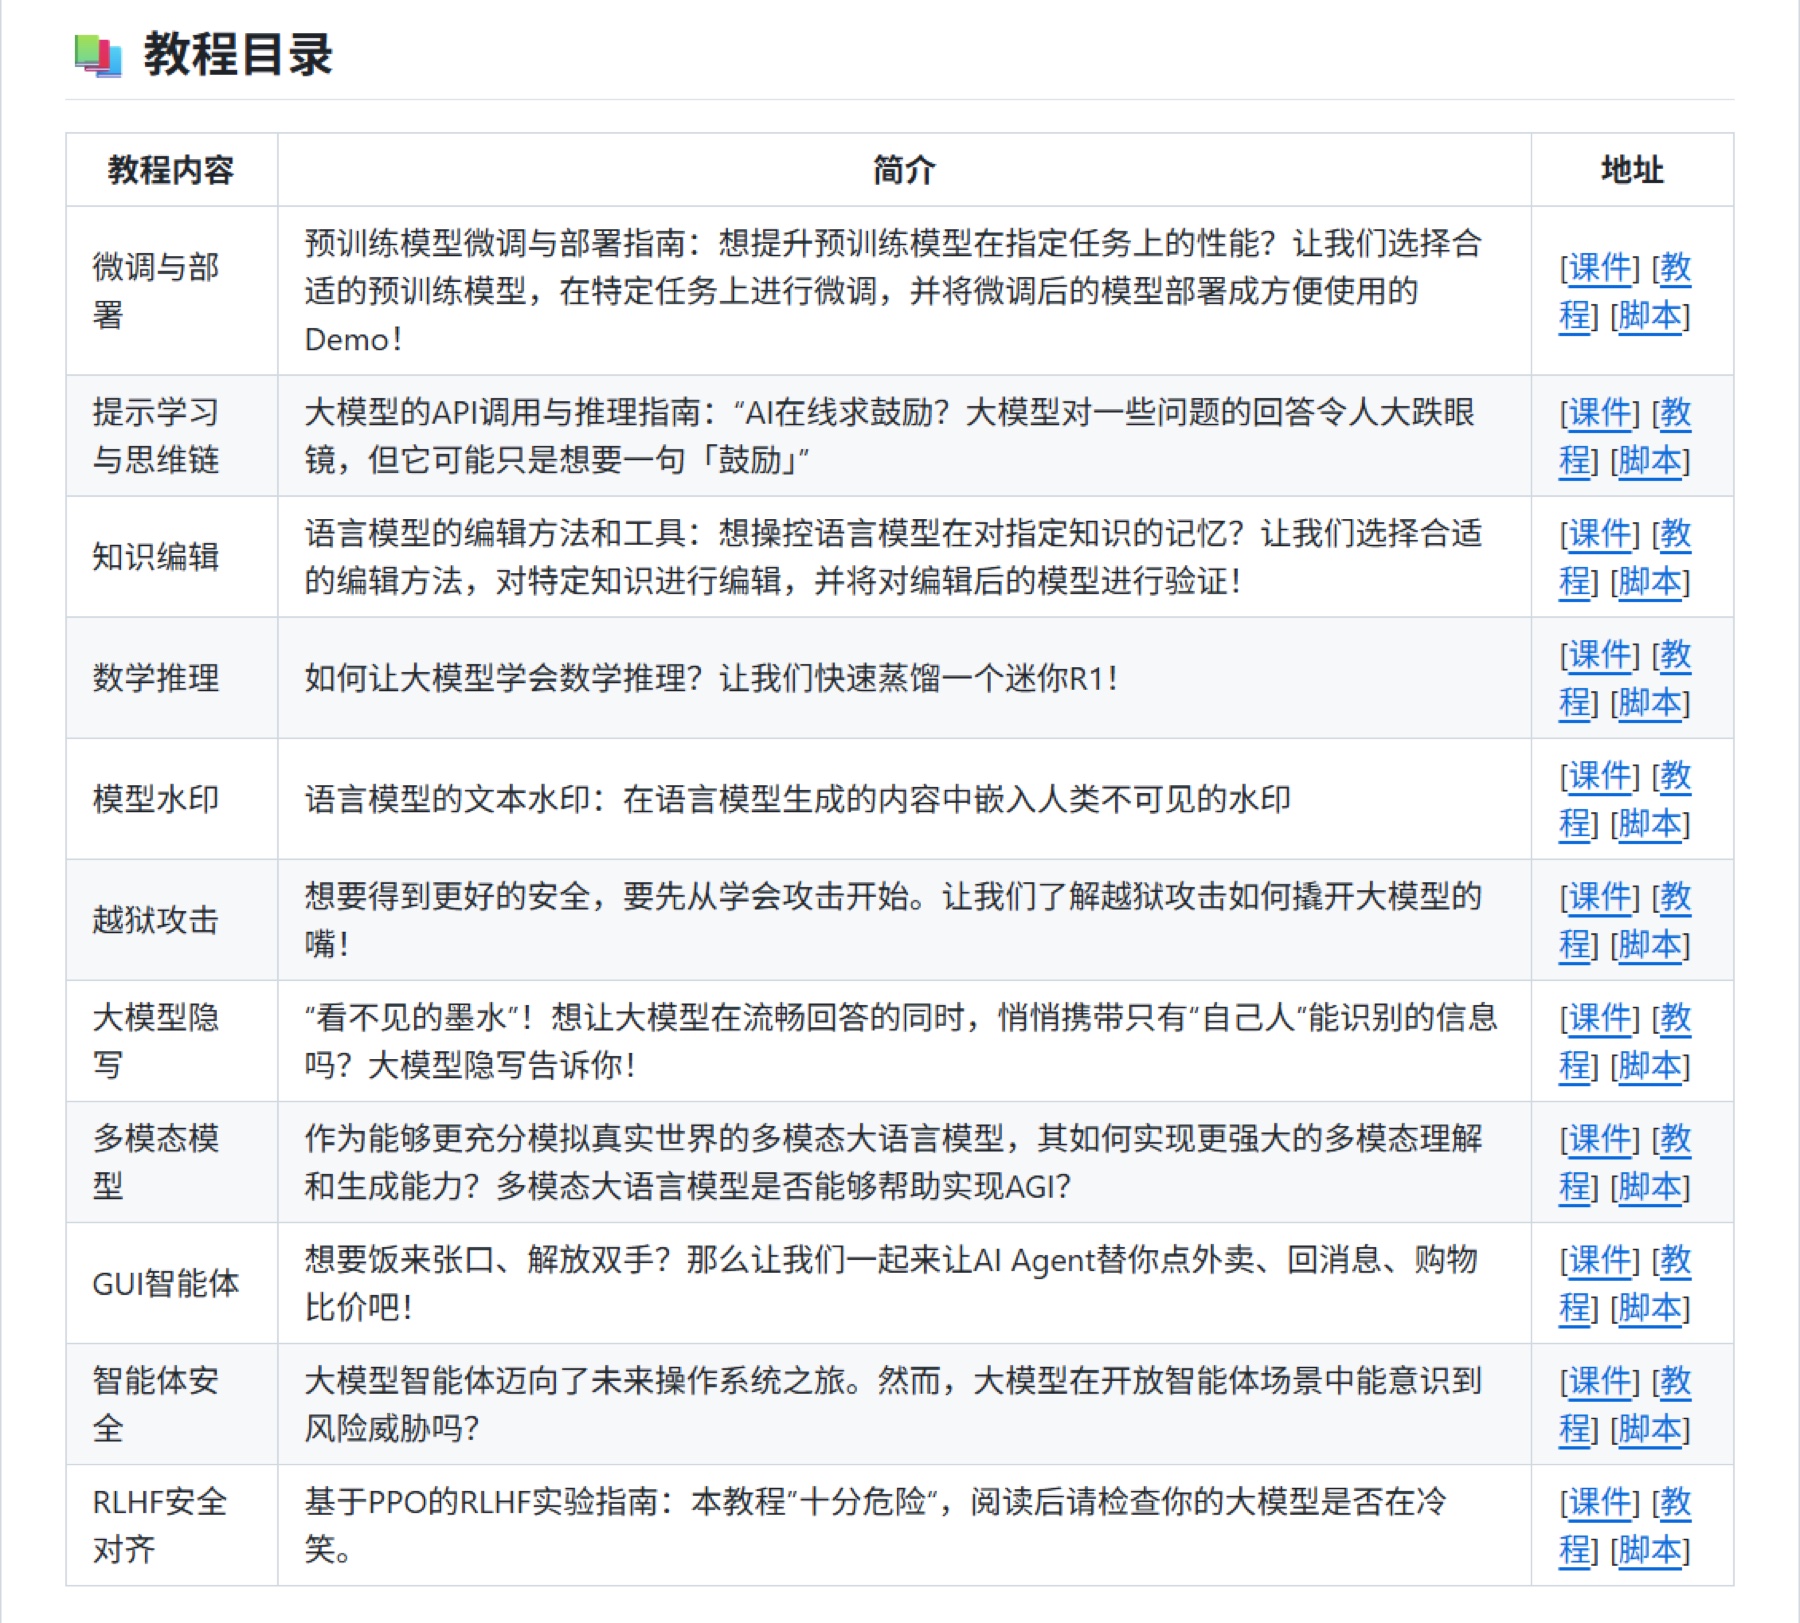
图片展示了学习大模型的教程目录。目录包含微调与部署、提示学习与思维链、知识编辑、数学推理、模型水印、越狱攻击、大模型隐写、多模态模型、GUI智能体、智能体安全、RLHF安全对齐等课程内容,每项课程均有简介、地址(含课程、教程、班型)。该图片与文档中介绍的“学习大模型的神仙开源项目”上下文相关,直观呈现了项目中各课程的名称、简介及获取方式,帮助用户了解项目内容。
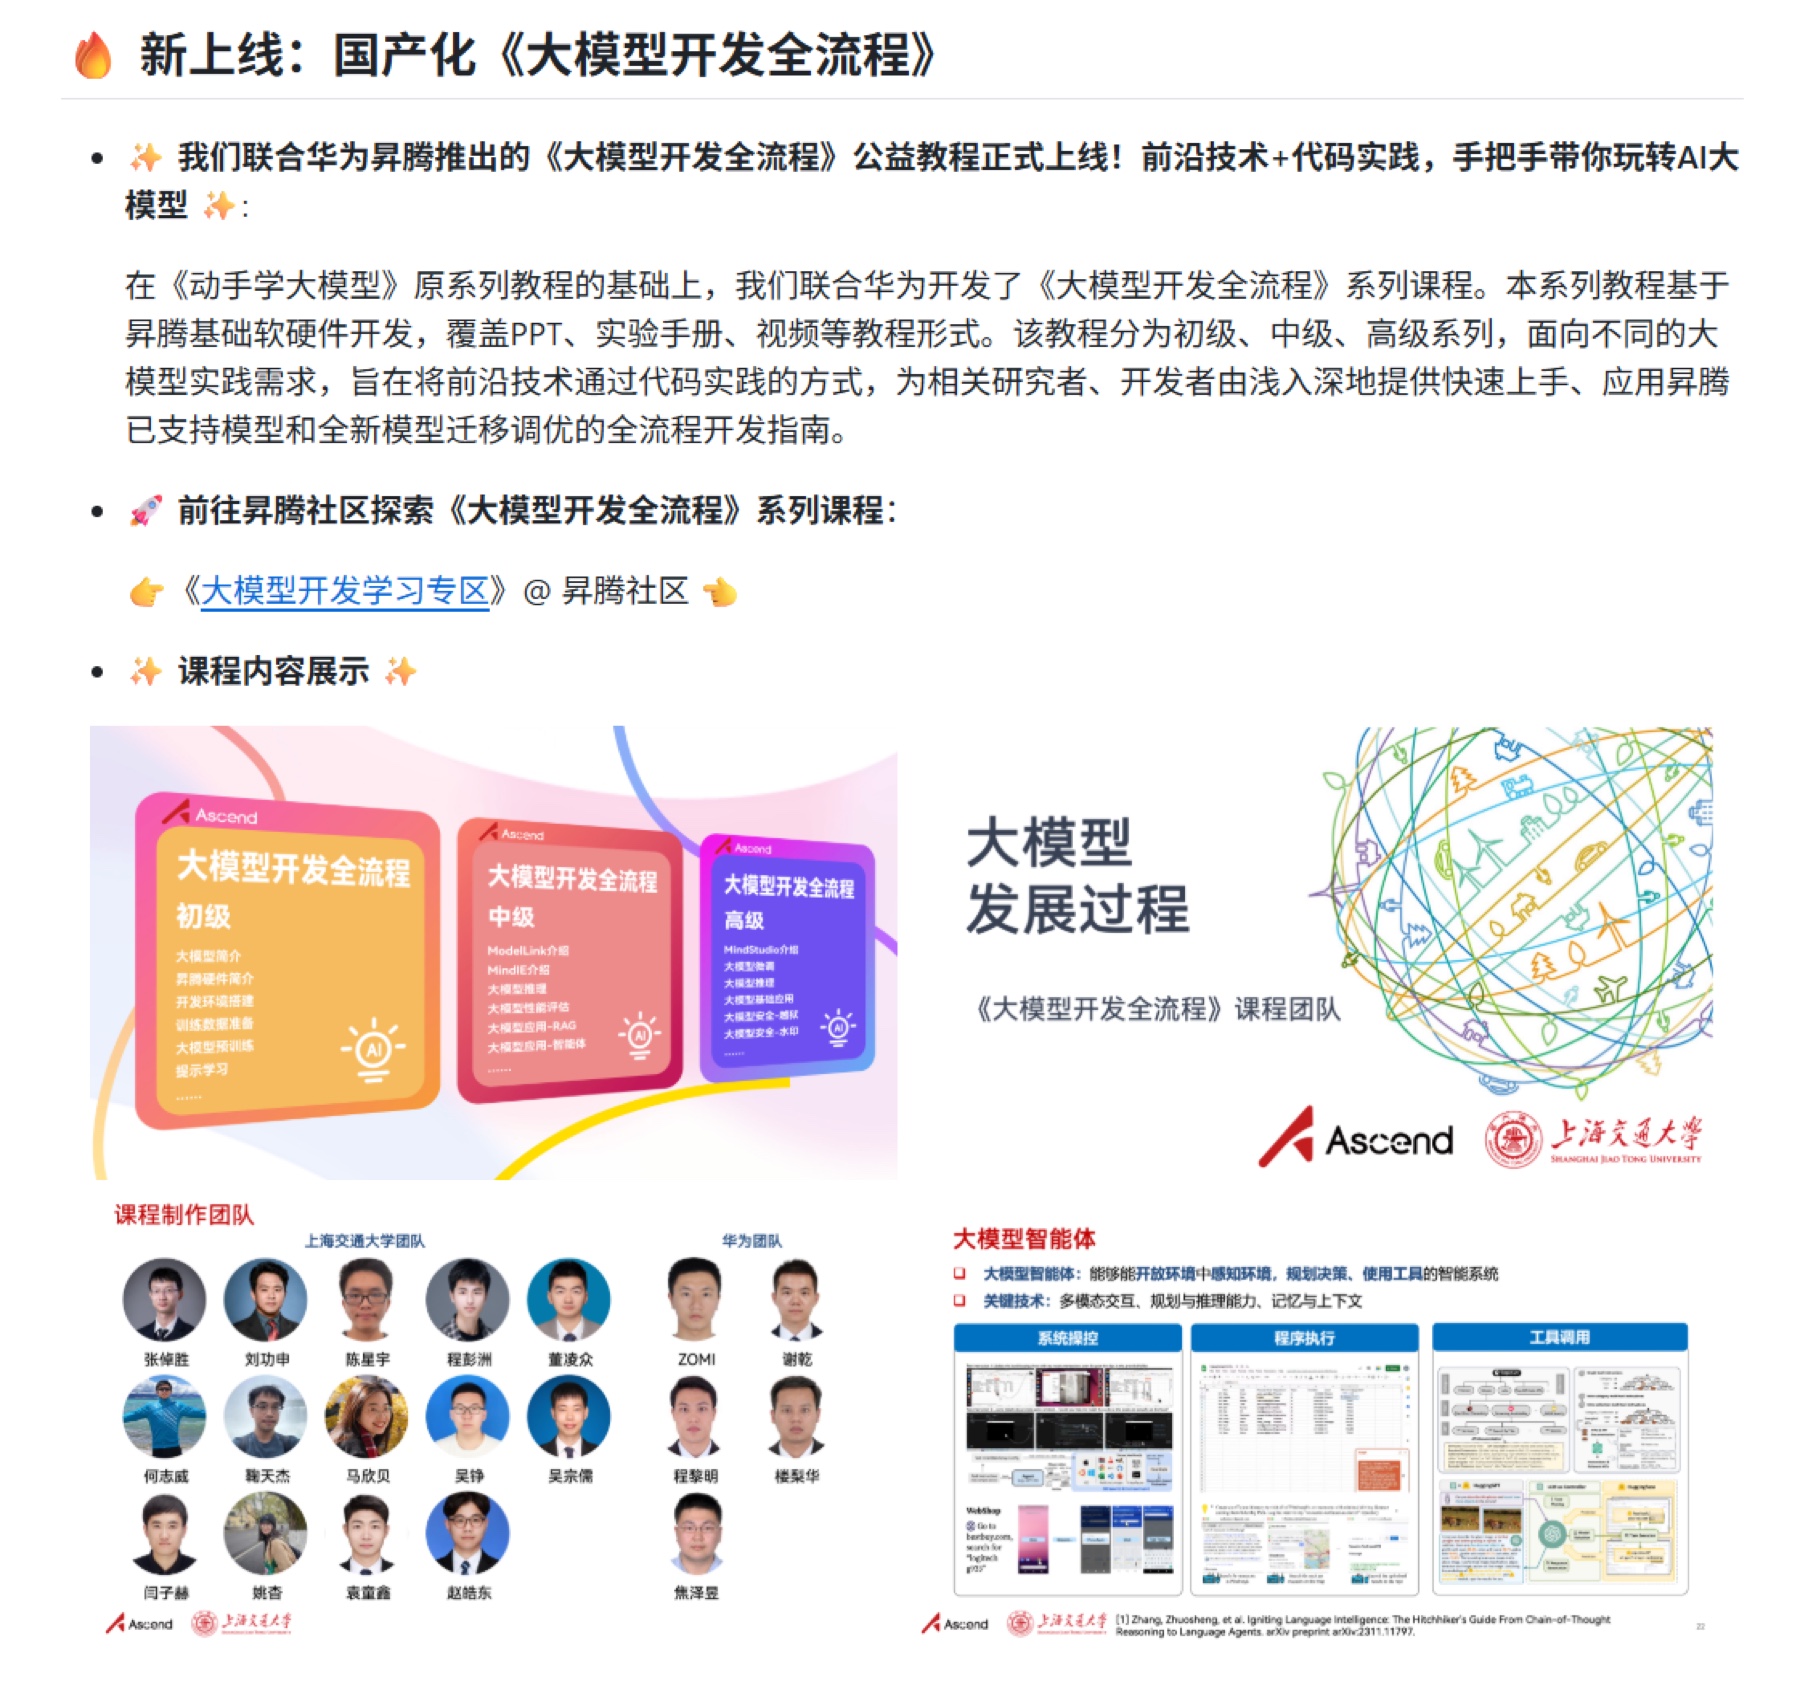
图片展示了华为昇腾联合上海交通大学推出的《大模型开发全流程》系列课程相关内容。课程分为初级、中级、高级三个级别,涵盖PPT、实验手册、视频等形式,面向不同大模型开发需求。图片中还呈现了课程制作团队成员头像,以及大模型发展过程、大模型智能体、工程实现等课程内容示例。该课程旨在通过代码实践,帮助相关研究者、开发者快速上手,提供全流程开发指南。
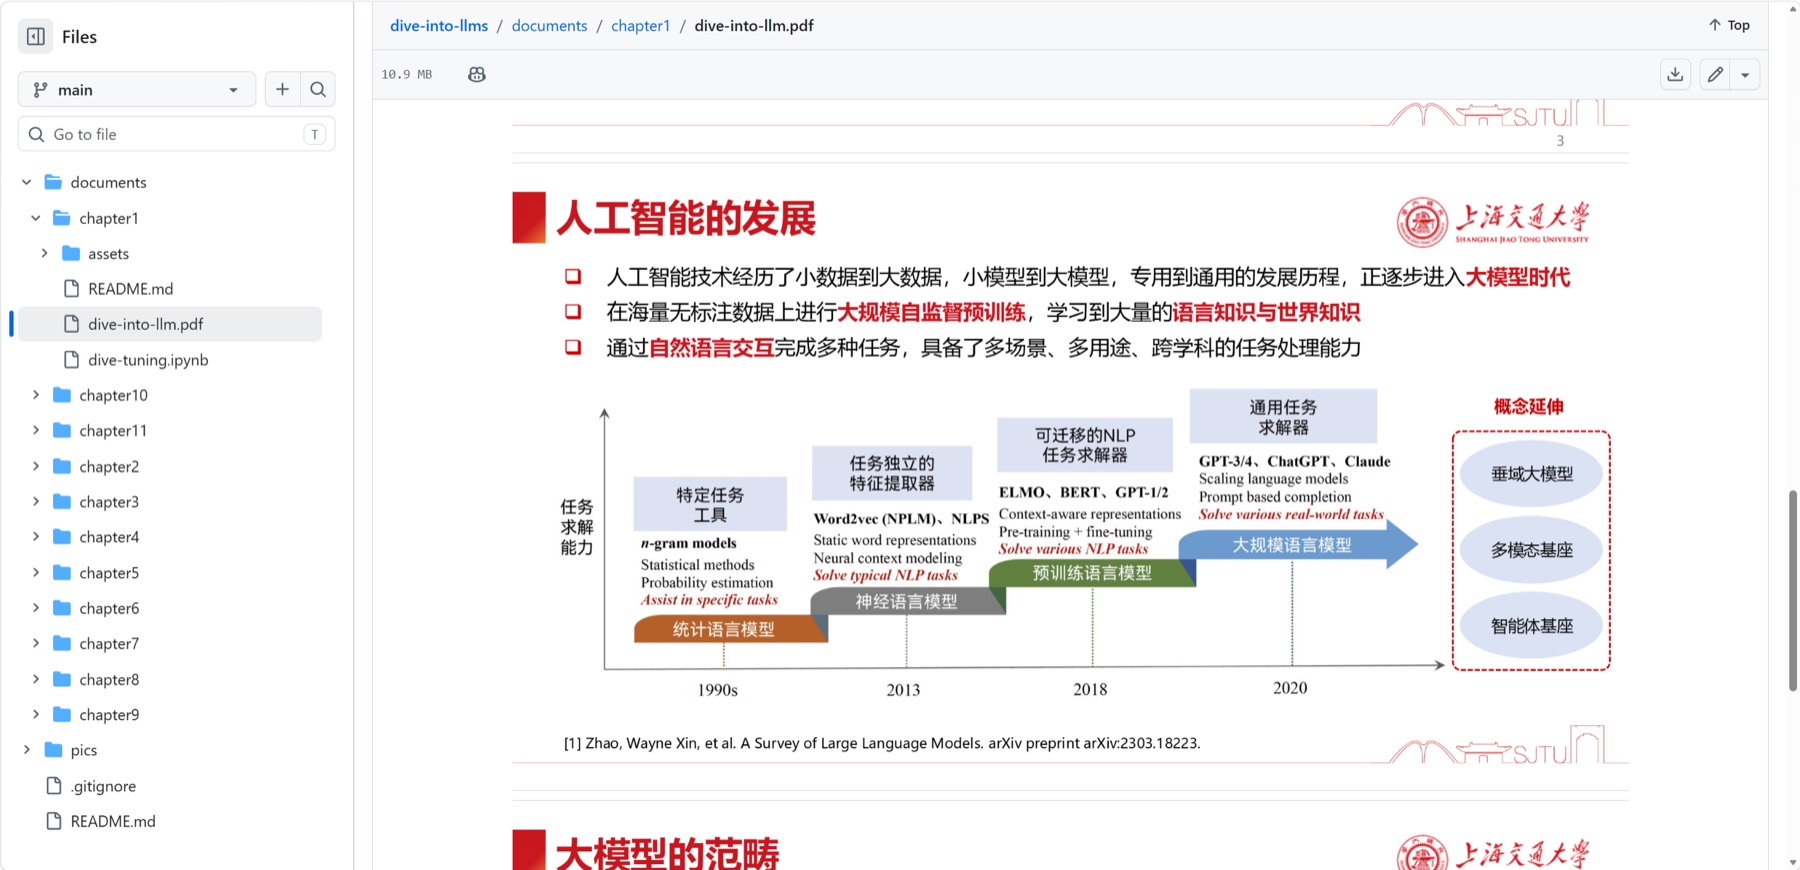
这张图片是上海交通大学的人工智能相关学术内容截图,展示了人工智能的发展历程:技术经历了小数据到大模型、专用到通用的发展,正逐步进入大模型时代;具体过程包括在海量无标注数据上进行大规模自监督预训练,学习大量知识与世界,还能通过自然语言交互完成多任务,具备多场景、多用途、跨学科的任务处理能力。图中梳理出不同阶段的典型模型,如2013年的Word2Vec、2018年的BERT、GPT-1-2,以及2020年的GPT-3.5、ChatGPT、Claude等,还标注了当前大模型的类别,包括基础大模型、多模态基础、智能体基座,该内容契合文档提及的项目中AI科研相关的实战与理论结合特点。
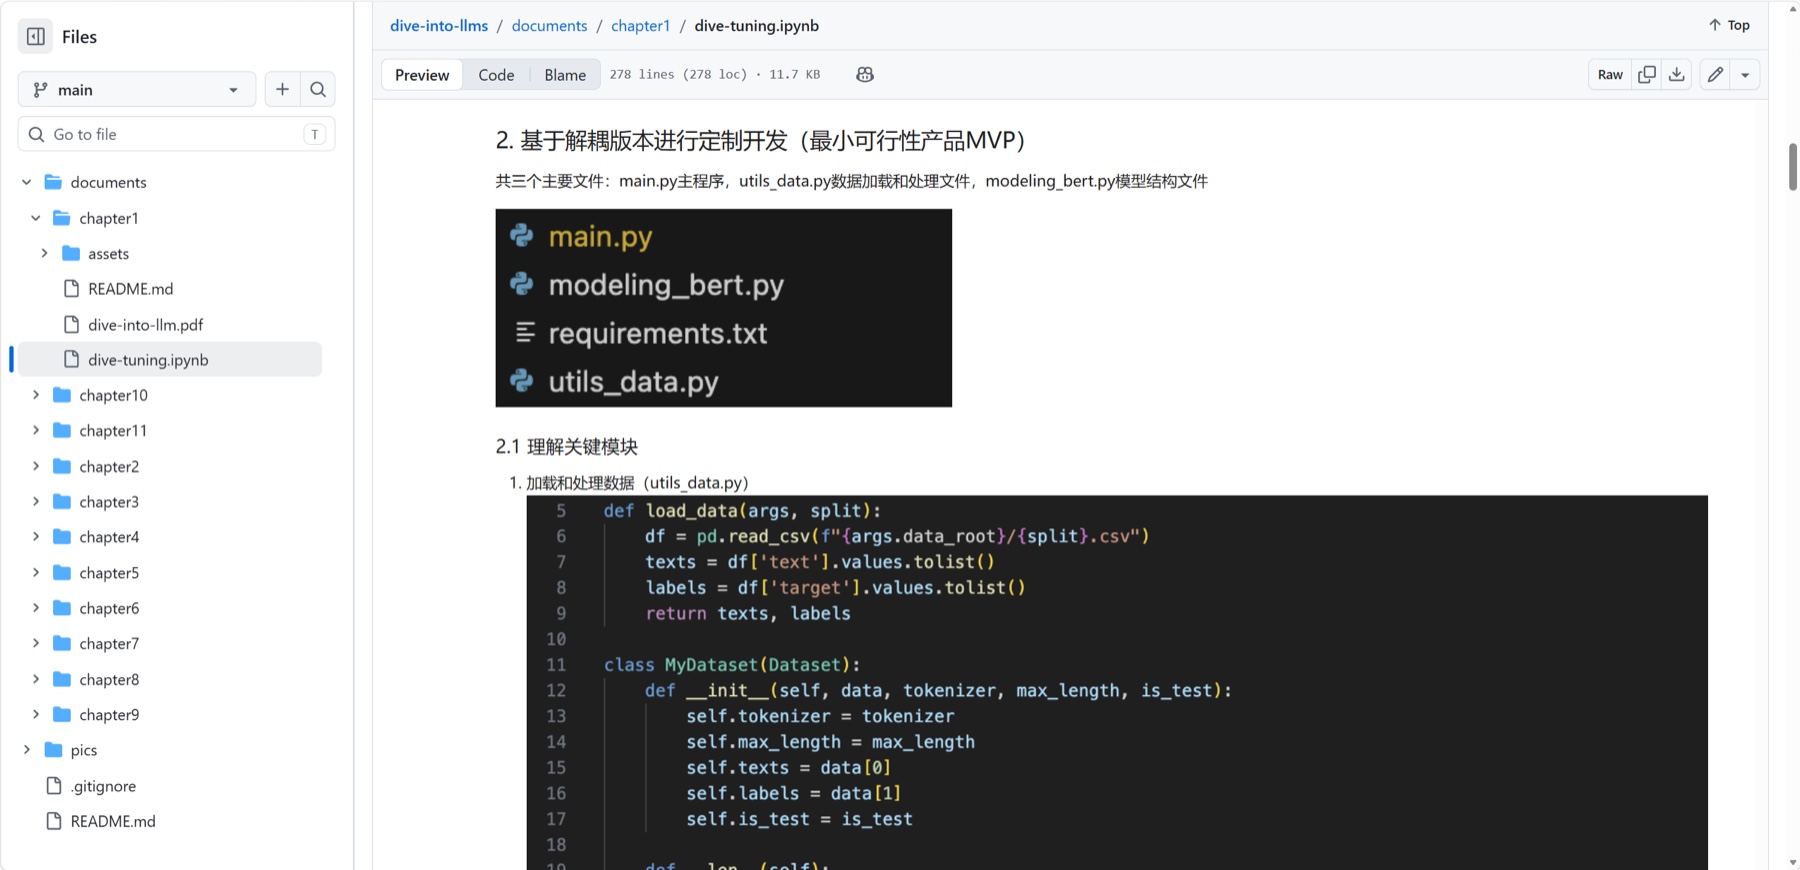
图片展示了“dive - tuning.ipynb”文件内容,是基于模板本进行定制开发的最小可行性产品MVP。文件包含三个主要文件:main.py主程序、utils_data.py数据加载和预处理文件、modeling_bert.py模型结构文件。还呈现了关键模块代码,如加载数据处理函数,将数据集按比例划分,读取CSV文件并提取文本和标签,以及MyDataset类定义,包含数据加载和预处理方法。该图与文档中介绍的项目实战导向优势相契合,直观呈现了代码复现与工程实现内容。